최근 ‘AI 팩토리 효율성’ 주제로 발표
AI 인프라 평가 기준 ‘전력당 토큰’으로 변화
에이전트 AI 확산에 기업 비용 부담 증가
삼성전자·SK하이닉스, HBM 대역폭 개선
PIM·CXL, 미래 메모리 설루션 준비도
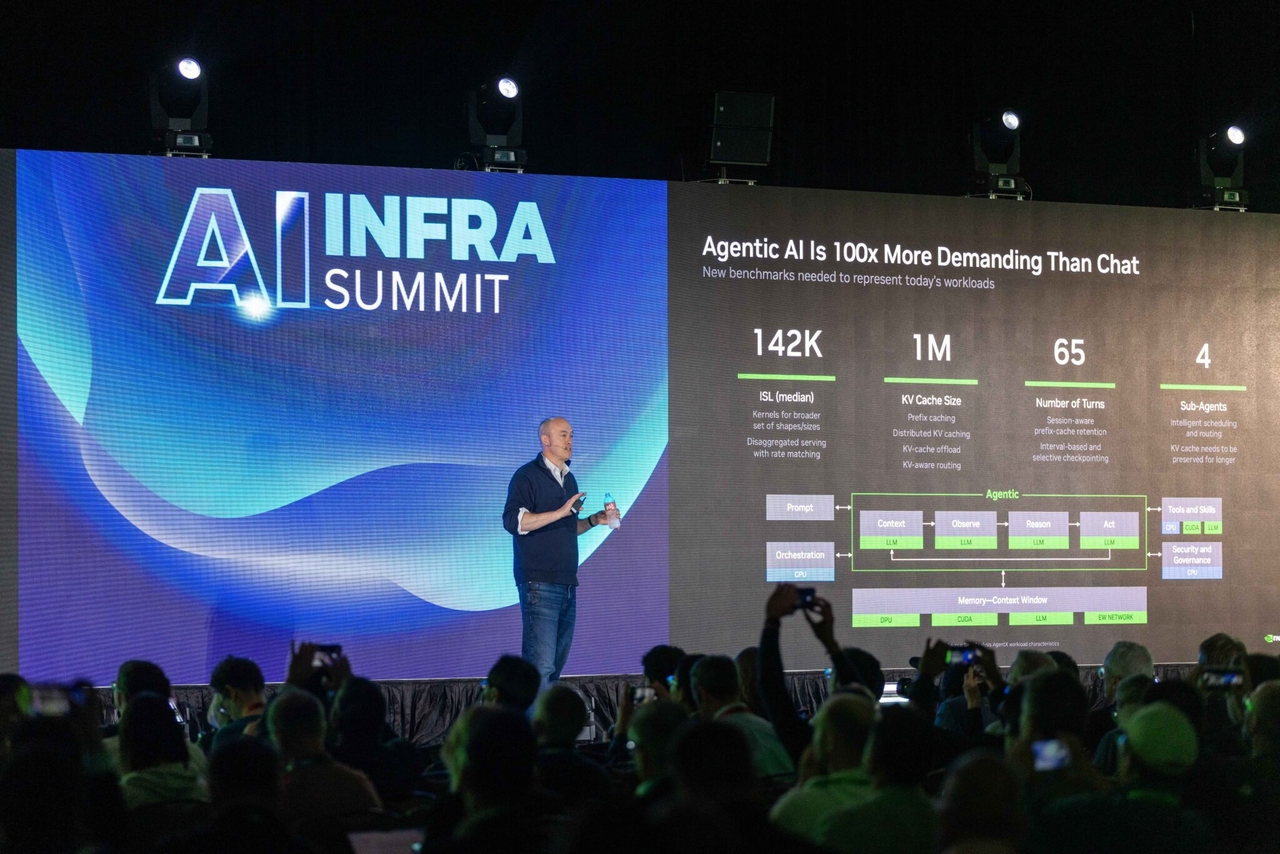 |
| 이안 벅 엔비디아 하이퍼스케일 및 고성능 컴퓨팅 부문 부사장이 이달 중순 미국 산타클라라에서 열린 ‘AI 인프라 서밋’에서 발표하고 있다. [엔비디아 제공] |
[헤럴드경제=이정완 기자] AI(인공지능) 반도체의 성능을 가르는 기준이 연산량에서 ‘토큰(token) 생산량’으로 변하고 있다. 제한된 전력과 비용 하에서 얼마나 많은 토큰을 빠르게 만들어내는지가 AI 데이터센터 수익성을 좌우하기 때문이다.
글로벌 반도체 업계도 토크노믹스 시대 해법 찾기에 한창이다. AI 컴퓨팅 기술을 선도하는 엔비디아는 전력 효율 최적화를 통해 AI 팩토리의 토큰 생산성을 극대화하고 있다. 전세계 메모리 반도체 투톱인 삼성전자와 SK하이닉스도 고대역폭메모리(HBM) 기술 고도화는 물론 메모리에 연산 기능을 추가해 이 같은 시장 흐름에 대응하고 있다.
24일 업계에 따르면 이달 중순 미국 캘리포니아주 산타클라라에서 열린 ‘AI 인프라 서밋’에서 이안 벅 엔비디아 하이퍼스케일 및 고성능 컴퓨팅 부문 부사장은 AI 팩토리의 효율성을 주제로 발표했다.
벅 부사장은 이 자리에서 AI 인프라의 평가 기준이 최고 성능에서 ‘메가와트당 에이전틱 토큰’으로 이동하는 트렌드에 대해 설명했다. 이를 위해 엔비디아는 반도체부터 전력망을 아우르는 최적화 작업에 앞장서고 있다는 것이다.
엔비디아는 블랙웰 서버 기반 DSX 맥스(Max)LPS를 통해 메가와트당 토큰 생산량을 최대 1.4배 높였다고 밝혔다. DSX 맥스LPS는 GPU와 랙 전반의 전력 소비를 지속적으로 모니터링하고 필요한 곳에 가용 전력을 동적으로 재할당한다. AI 클라우드 제공업체 람다(Lambda)가 AI 인프라 서밋에서 엔비디아와 함께 이 같은 검증 결과를 발표했다.
데이브 워드 람다 클라우드 서비스부문 사장은 “이번 개념 검증(PoC)을 통해 고정된 전력 예산의 한계를 넘어설 수 있음을 확인했다”며 “엔비디아 DSX 맥스LPS는 동일한 설치 면적에서 컴퓨팅 밀도를 획기적으로 높임으로써 활용되지 못했던 전력 용량을 실제 사용 가능한 자원으로 전환할 수 있는 길을 열어준다”고 말했다.
토큰은 AI가 문장과 이미지 등 데이터를 처리하기 위해 잘게 나눈 기본 단위다. 초당 처리 토큰이 많을 수록 LLM(대규모언어모델)이 더 빠른 답변을 제공할 수 있다. 특히 스스로 추론하는 에이전트 AI 확산에 따라 토큰 사용량이 급증하고 있다.
AI 도입에 한창인 기업들도 토큰 비용 증가를 거스를 수 없는 흐름으로 받아들이고 있다. 회계적으로도 토큰 비용이 고정비로 자리를 잡을 것이란 분석이 나온다. AI 모델을 사용하는 기업들의 수익성 개선을 위해서라도 토큰 생산성 향상은 앞으로 더욱 중요하게 다뤄질 수밖에 없다.
삼성전자와 SK하이닉스 같은 반도체 기업은 메모리 기술 고도화를 통해 토큰 생산성을 끌어올리려 한다. 현 시점에서는 HBM 대역폭(Bandwith)을 높여 AI 병목 해소에 나서고 있다.
올해 상반기 양사가 모두 주요 고객사에 샘플을 선보인 7세대 HBM4E의 경우 전작 대비 대역폭을 끌어올리고 에너지 효율도 개선했다. 삼성전자 HBM4E는 초당 3.6TB(테라바이트) 대역폭을 제공해 LLM 연산 속도를 극대화했다. SK하이닉스의 경우 핀당 최대 16Gbps 데이터 처리 속도를 구현했다.
미래 메모리 기술로 거론되는 PIM(Processing-In-Memory)도 대표적인 토큰 최적화 기술로 거론된다. 삼성전자는 지난달 말 저전력 D램(LPDDR)에 연산 기능을 더한 LPDDR5X-PIM을 선보였다. SK하이닉스도 AI 인프라 서밋 2026에서 메모리에 연산 기능을 더한 ‘AiM’ 칩과 이를 여러 개 탑재한 가속기 카드 ‘AiMX’를 전시했다.
저전력 D램이 데이터 저장만 담당할 때는 CPU(중앙처리장치)·GPU(그래픽처리장치) 같은 연산기로 데이터를 보내야 했다. 하지만 메모리가 직접 간단한 연산을 처리할 경우 대역폭을 크게 개선할 수 있다.
LLM과 대화가 길어질수록 커지는 KV캐시(Key-Value Cache)를 어디에 저장할지도 토큰 생산량을 좌우한다. 메모리 저장 용량을 획기적으로 높일 수 있는 CXL(Compute eXpress Link)이 해법으로 여겨진다. CXL은 CPU, GPU(그래픽처리장치), 메모리를 유기적으로 소통할 수 있도록 만드는 차세대 연결 기술이다. 양사 모두 CXL 기반 메모리 모듈을 통해 시장 개화에 대비하고 있다.
 |
| 비즈360 |